
03Bread RAG · 第 4 章
总进度 19 / 33多文档 + 持久化索引
ch02 每次启动都会重新调用 embedding API 处理文档。如果文档没变,这部分工作就重复了,还会增加等待和用量。本章把算好的索引保存下来,下次直接加载。
2026-09-28约 40 分钟280 行代码难度 ★★
如果想获取全套课程资料,请关注微信公众号 「AI面包君」,回复 「课程资料」 即可领取。
1. 保存已经算好的文档向量
ch02 每次启动都会重新调用 embedding API 处理文档。如果文档没变,这部分工作就重复了,还会增加等待和用量。本章把算好的索引保存下来,下次直接加载。
同时把单篇文档扩展为 docs/ 下的多份文件,并保留来源,方便找到答案后回查原文。
这一章我们做 4 件事:
- 读取
docs/中的多份 Markdown 文档。 - 通过
add_documents向现有索引追加内容。 - 用 pickle 保存片段和向量,避免每次重算。
- 用
RAGIndex集中提供添加、搜索、保存和加载方法。
文件结构:
ch03_persist/
├── rag.py        # ★ RAGIndex 类(本章核心)
├── main.py       # 端到端 demo
├── docs/
│   ├── bread_workshop.md
│   ├── hr_policy.md
│   └── rd_roadmap.md
├── index.pkl     # 首次运行后生成
└── README.md
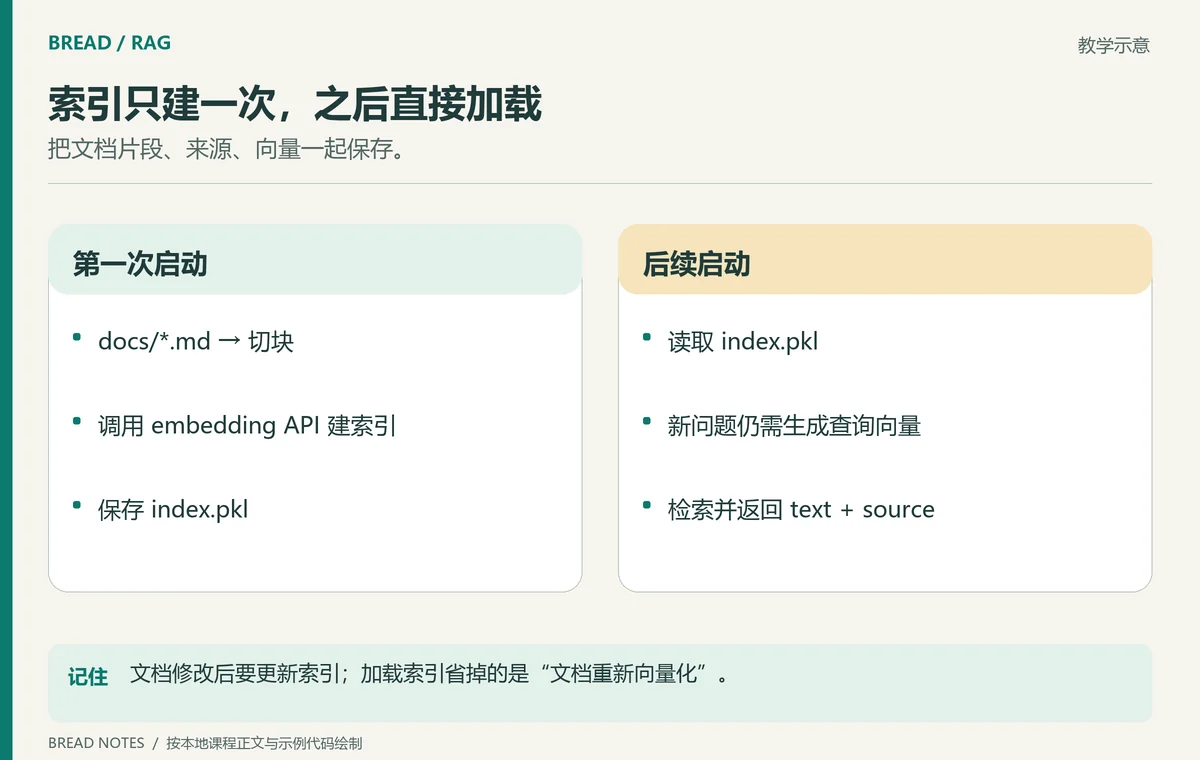
<!-- bread-visual:end -->图解: 把文档片段、来源、向量一起保存。 文档修改后要更新索引;加载索引省掉的是“文档重新向量化”。
2. 跑起来
第一次跑:从零建库
cd ch03_persist
python main.py
应该看到:
[索引] 没找到 index.pkl,从 docs/ 目录新建...
[索引] 新增 13 个 chunks,索引总量 13
[索引] 已保存到 index.pkl (120 KB)

=== 问题 1: 公司在哪儿?什么时候成立的? ===
[检索] top-3 命中:
  - [bread_workshop.md] (cos=0.531) ## 一、关于公司
  ...
AI: ...总部位于上海,成立于 2018 年。[bread_workshop.md]
第二次运行:从磁盘加载文档索引,省去文档重新向量化;查询本身仍需生成向量。
python main.py
第一行变成:
[索引] 从 index.pkl 加载了 13 个 chunks
比较两次启动日志,确认第二次读取了已保存的索引。再记录耗时,区分文档建库、问题向量化和生成回答分别花了多久。
3. 对照代码看实现
Chunk 数据类
试读到这里 · 后续内容已封存
关注公众号,继续把这章学完
在「AI面包君」发送关键词「学习AI」拿到口令。验证一次,这个浏览器就能继续阅读全部课程。