
03Bread RAG · 第 2 章
总进度 17 / 33手写词袋检索(BoW + 余弦)
ch00 每次都发送全文。现在尝试先找出与问题相关的几段,看看能否用更少的资料回答同一组问题。
2026-09-28约 50 分钟150 行代码难度 ★★★
如果想获取全套课程资料,请关注微信公众号 「AI面包君」,回复 「课程资料」 即可领取。
1. 先找相关段落,再生成回答
ch00 每次都发送全文。现在尝试先找出与问题相关的几段,看看能否用更少的资料回答同一组问题。
RAG 的核心思路是**"先检索后生成"**:
                     用户提问
                        │
       ┌────────────────┼────────────────┐
       │                                 │
       ▼                                 │
+--------------+      检索 (cosine)       │
|  向量索引     │ ◄───────────────────────┘
|  (offline)   │
+--------------+
       │
       │  返回 top-3 最相关的片段
       ▼
+----------------------+
| 拼进 prompt 给 LLM    |
+----------------------+
       │
       ▼
       AI 的回答
检索部分先做三件事:
- 切块(chunking):长文档切成几十段
- 向量化(embedding):每段表达成一组数字
- 检索(retrieval):用户提问 → 提问也向量化 → 找出最相似的几段
这一章我们用最朴素的方式做这 3 件事——纯 Python 标准库,零 ML 依赖:
- 切块:按 markdown
##标题切 - 向量化:词袋(Bag of Words,每个词出现几次)
- 相似度:余弦相似度
运行后,把检索分数与原文对照,就能看到一段文字是怎样被选中的。这个小例子只展示基本计算,不包含向量数据库的全部功能。
<!-- bread-visual:start -->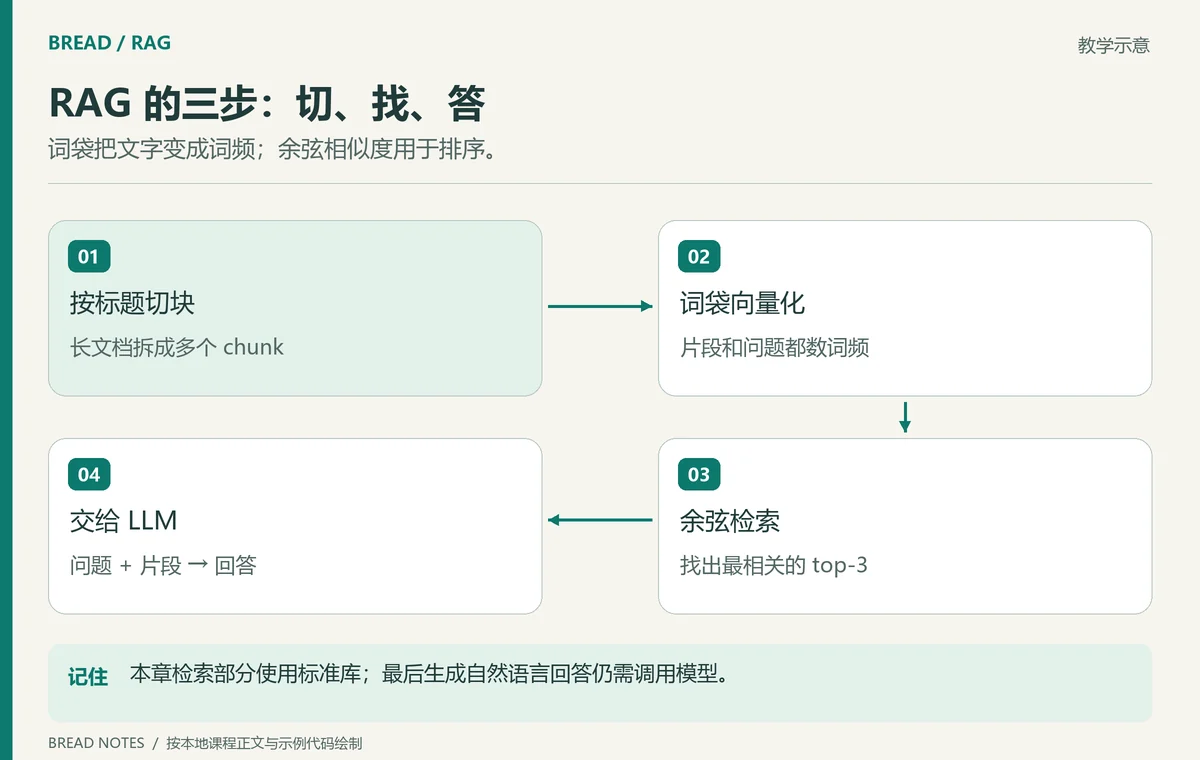
<!-- bread-visual:end -->图解: 词袋把文字变成词频;余弦相似度用于排序。 本章检索部分使用标准库;最后生成自然语言回答仍需调用模型。
2. 跑起来
cd ch01_bow
python main.py
预期输出:
[索引] 文档切成 9 个 chunks
[索引] 平均每个 chunk 59 个不同词

=== 问题 1: 你们公司哪一年成立的? ===
[检索] top-3 片段:
  - 第1块 (cos=0.247) ## 一、关于公司
  - 第2块 (cos=0.117) ## 二、产品线
  - 第3块 (cos=0.081) ## 三、原料采购
AI: Bread 面包工坊成立于 2018 年。

=== 问题 2: 加盟费是多少?培训要多久? ===
[检索] top-3 片段:
  - 第5块 (cos=0.338) ## 五、加盟政策
  ...
AI: 加盟费 38 万元,培训时长 14 天...

...
关键观察:
- 每个问题先显示 top-3 片段和相似度。
- 模型收到的是这些片段,而非整篇文档。
- 对照原文检查五个回答,记录检索和生成分别有没有出错。
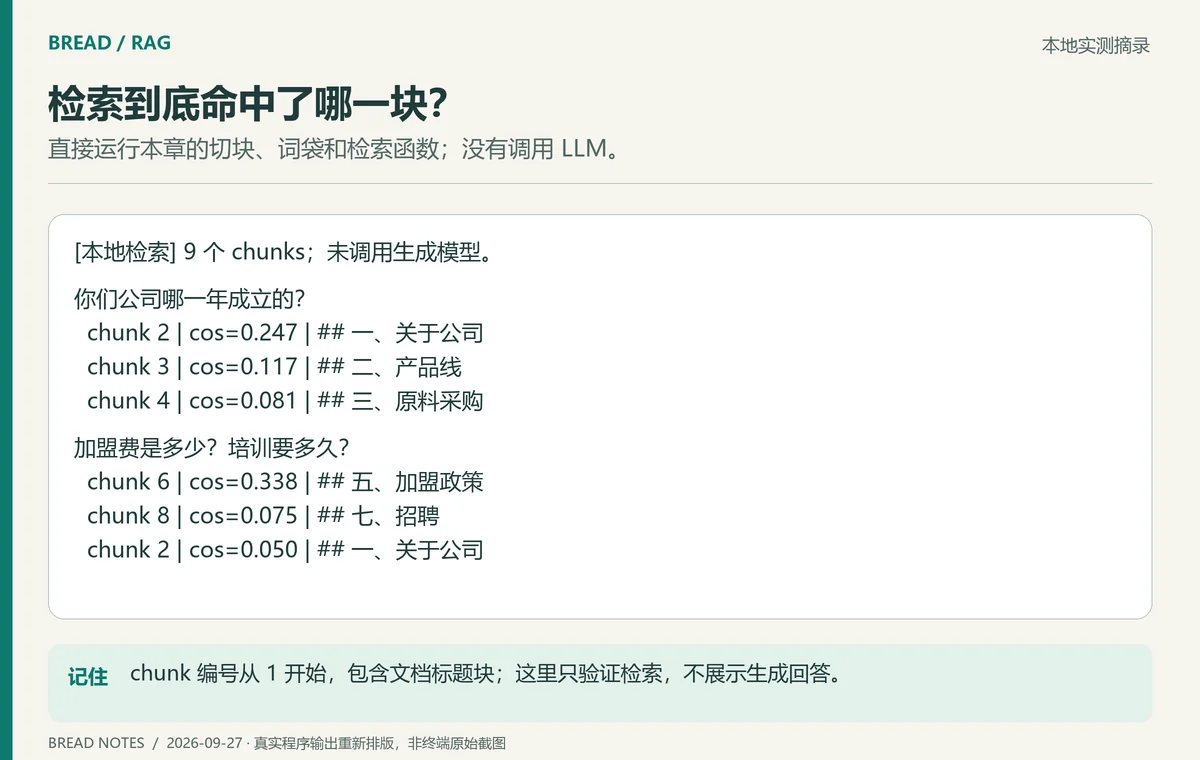
运行结果: 直接运行本章的切块、词袋和检索函数;没有调用 LLM。 chunk 编号从 1 开始,包含文档标题块;这里只验证检索,不展示生成回答。 图中是实际输出的排版摘录,完整记录保存在根目录的配图工作文件中。
试读到这里 · 后续内容已封存
关注公众号,继续把这章学完
在「AI面包君」发送关键词「学习AI」拿到口令。验证一次,这个浏览器就能继续阅读全部课程。