
03Bread RAG · 第 3 章
总进度 18 / 33用 embedding 模型做语义检索
用户的说法 文档的说法 字面检索要面对的差异 公司在哪儿? 总部位于上海 用词不同 vegan 选项 植物基 语言不同 小麦粉从哪里来? 原料采购 问法与栏目名不同 想退货可以吗? 退换货政策 有共同字,但还要看排序和具体条款
2026-09-28约 40 分钟200 行代码难度 ★★
如果想获取全套课程资料,请关注微信公众号 「AI面包君」,回复 「课程资料」 即可领取。
1. 换一种说法,还能找到原文吗?
ch01 的词袋(BoW)检索能用,但它只看字面:
| 用户的说法 | 文档的说法 | 字面检索要面对的差异 |
|---|---|---|
| 公司在哪儿? | 总部位于上海 | 用词不同 |
| vegan 选项 | 植物基 | 语言不同 |
| 小麦粉从哪里来? | 原料采购 | 问法与栏目名不同 |
| 想退货可以吗? | 退换货政策 | 有共同字,但还要看排序和具体条款 |
用户未必知道文档中的准确用词。如果只能靠重复的字词,相关资料就可能排不到前面。
本章用 embedding 模型把文本转换成一组数字,尝试把相关的不同说法表示得更接近。示例 bge-m3 返回 1024 维向量,具体效果仍要通过检索结果检查。
流程仍然是先表示文本、再计算相似度、最后取片段。主要变化是:词频 Counter 换成了模型返回的向量。对照 ch01 阅读,会更容易找到这部分改动。
<!-- bread-visual:start -->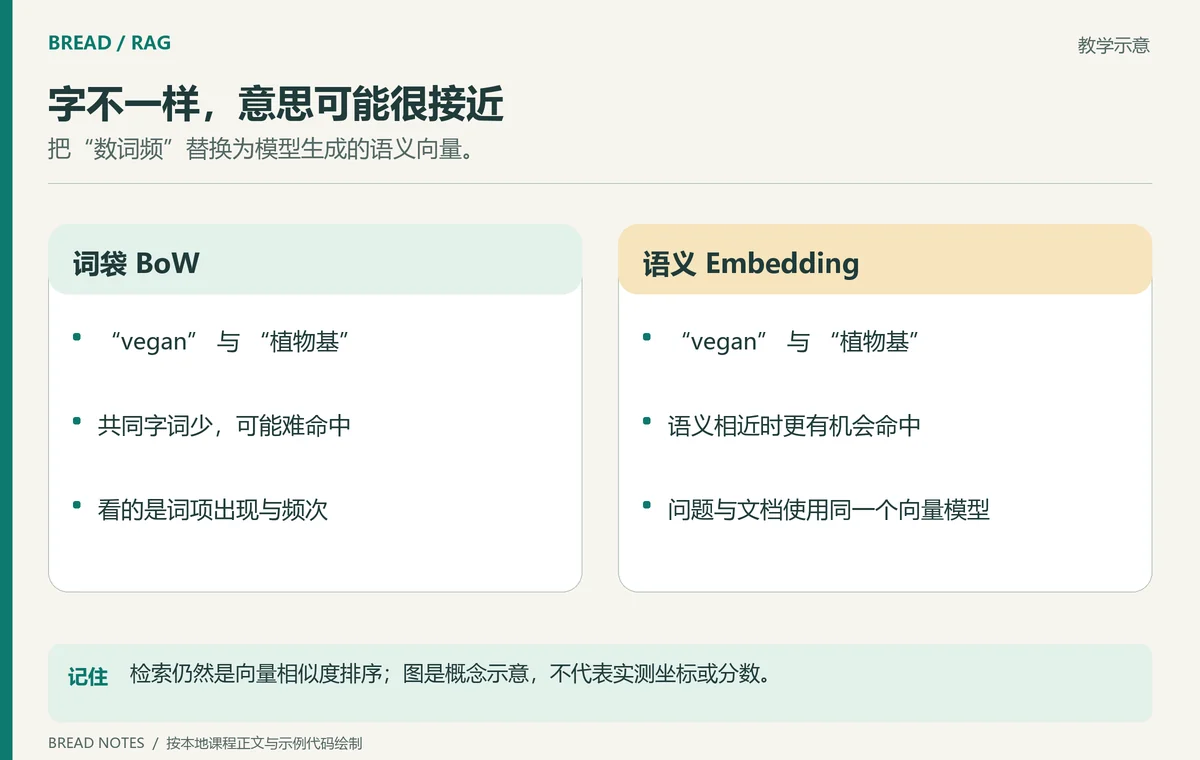
<!-- bread-visual:end -->图解: 把“数词频”替换为模型生成的语义向量。 检索仍然是向量相似度排序;图是概念示意,不代表实测坐标或分数。
2. 跑起来
cd ch02_embeddings
python main.py
本章需要 embedding key。如果你跟着课程在
.env里配了EMBEDDING_*三行,开箱即用。 没配的话看仓库顶层 README 的 ".env 配置"小节。
预期输出(关键对比 ch01):
=== 问题 1: 公司在哪儿? ===
[检索] top-3 片段:
  - 第1块 (cos=0.513) ## 一、关于公司       ← BoW 这里基本是 0
  - 第7块 (cos=0.420) ## 七、招聘
  - 第5块 (cos=0.402) ## 五、加盟政策
AI: 总部位于上海。

=== 问题 2: 你们卖的 vegan 选项有哪些? ===
[检索] top-3 片段:
  - 第6块 (cos=0.599) ## 六、研发动态         ← "vegan" ≈ "植物基" 命中了
  - 第2块 (cos=0.581) ## 二、产品线
  - 第8块 (cos=0.541) ## 八、客户常见问题
AI: 目前有植物基羊角面包,正在研发中,预计 7 月推出。

=== 问题 3: 小麦粉是从哪里来的? ===
[检索] top-3 片段:
  - 第3块 (cos=0.645) ## 三、原料采购         ← "从哪里来" ≈ "采购"
  ...
试读到这里 · 后续内容已封存
关注公众号,继续把这章学完
在「AI面包君」发送关键词「学习AI」拿到口令。验证一次,这个浏览器就能继续阅读全部课程。