
真正的 Agent 循环
让模型开始动手。真正的 Agent 循环,边读边运行配套 Python 代码。
1. 故事:单步不够,要多步
ch01 我们让 AI 调了一次工具。但真实任务往往要多步配合:
用户:把 README.md 第一行内容写到 hello.txt
AI 内部要做的事情:
- 调
read_file("README.md")拿到全文- 切出第一行(这一步 LLM 自己脑子里就能做)
- 调
write_file("hello.txt", first_line)- 用中文告诉用户"完成了"
这需要 3 步才能完成(第 1、3 步要调工具,第 4 步是最终回答)。ch01 那种"两次请求 + 一次执行"完全不够用。
这就是为什么我们需要一个循环——反复地:"调模型 → 拿到工具请求 → 执行工具 → 把结果写回 messages → 再调模型 ...",直到模型不再要求调工具为止。
这个循环就是 agent 的心脏。pi-main 那 700 行 TypeScript 的灵魂,浓缩成 Python 就 10 行:
for step in range(MAX_STEPS):
    response = client.chat.completions.create(messages=messages, tools=TOOLS_SCHEMA)
    msg = response.choices[0].message
    messages.append(msg)

    if not msg.tool_calls:
        return msg.content        # ← 出口:模型不要求调工具了,任务结束

    for call in msg.tool_calls:
        result = TOOLS_IMPL[call.function.name](**json.loads(call.function.arguments))
        messages.append({"role": "tool", "tool_call_id": call.id, "content": str(result)})
把这 10 行背下来。 任何一个 LLM agent,无论它叫 LangChain 还是 AutoGen 还是 Claude Code,最底层都是这 10 行所反映的思想。
2. 跑起来
cd ch02_loop
python main.py

此时main函数中输入的需求是:读取origin.txt文件的前3行,并把第1行内容写入到一个到文件new.txt中
Anaconda 同学:
D:\anaconda3\envs\yutong\python.exe main.py
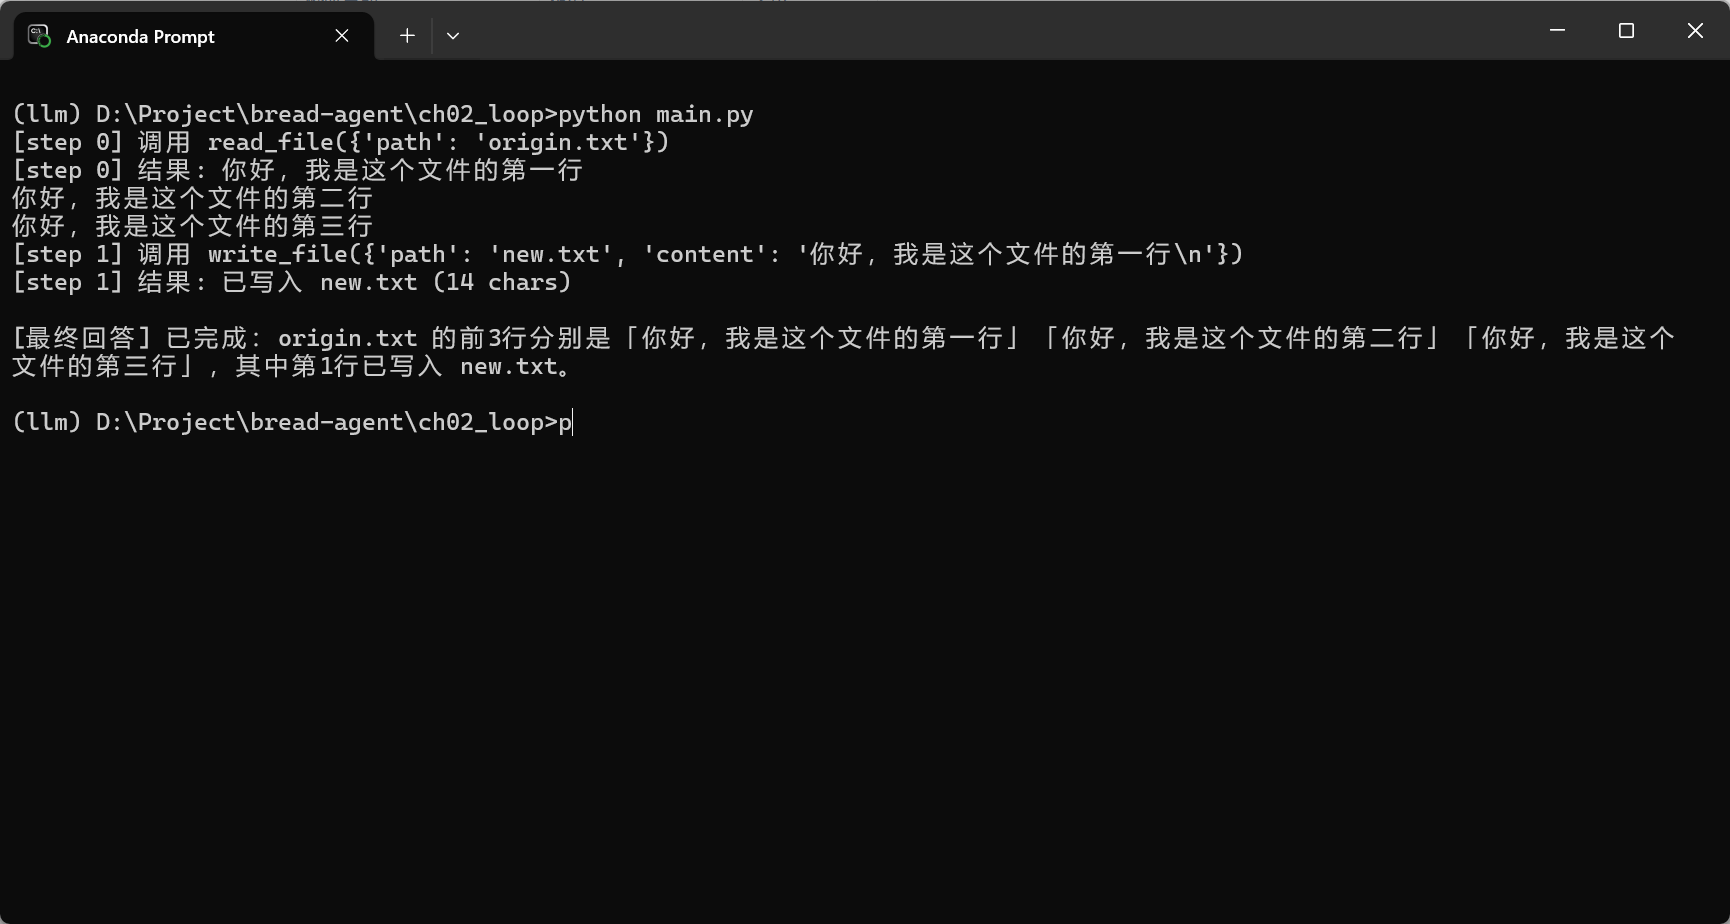
预期输出
[step 0] 调用 read_file({'path': 'origin.txt'})
[step 0] 结果: 你好,我是这个文件的第一行
你好,我是这个文件的第二行
你好,我是这个文件的第三行
[step 1] 调用 write_file({'path': 'new.txt', 'content': '你好,我是这个文件的第一行\n'})
[step 1] 结果: 已写入 new.txt (14 chars)

[最终回答] 已完成:origin.txt 的前3行分别是「你好,我是这个文件的第一行」「你好,我是这个文件的第二行」「你好,我是这个文件的第三行」,其中第1行已写入 new.txt。
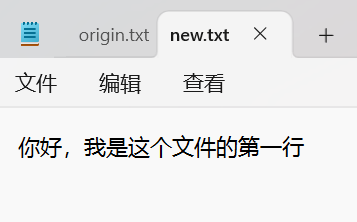
注意几件事:
[step 0]这一行说明 agent 在循环的第 0 步- AI 没有直接编一个"第一行是什么"的答案,它先去真的读了文件
- 整个过程,AI 调了 1 次工具,循环跑了 1 步,然后输出最终答案
如果你跑通了这章,你已经掌握了 agent 的本质。
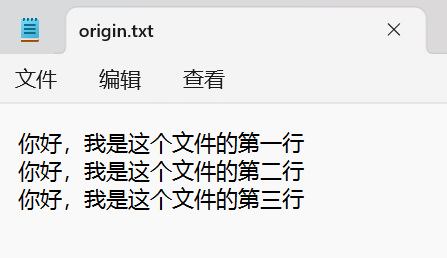
3. 逐行精讲:心脏在 run_agent 函数
打开 main.py,最重要的就是 run_agent 函数(约 120 行处)。我们一段段看。
第 1 段:循环的外壳
MAX_STEPS = 10  # 安全阀

def run_agent(user_input: str) -> str:
    messages = [
        {"role": "system", "content": "你是一个能操作文件系统的中文助理..."},
        {"role": "user", "content": user_input},
    ]

    for step in range(MAX_STEPS):
        # ... 单步 ...
为什么是 for step in range(MAX_STEPS) 而不是 while True?
万一模型陷入"工具老报错→反复重试"的死循环(确实会发生),不能让它无限烧 token。设 10 步基本够,复杂任务可以调大。这叫安全阀。
第 2 段:调模型 + append
response = client.chat.completions.create(
    model=MODEL,
    messages=messages,
    tools=TOOLS_SCHEMA,
)
assistant_msg = response.choices[0].message
messages.append(assistant_msg)
跟 ch01 一样。关键:messages.append(assistant_msg) 不能省——哪怕 assistant_msg 没有 content,只有 tool_calls,也要 append。否则下次请求时 tool 消息找不到对应的 tool_calls,OpenAI 协议会拒绝。
第 3 段:停止条件 ★
if not assistant_msg.tool_calls:
    return assistant_msg.content or ""
这是循环的唯一出口。
含义:模型这次返回了纯文本(没有 tool_calls),说明它已经收集到足够信息、能给最终答案了。这一行的判断决定了 agent 何时"觉得自己做完了"。
你不需要写"判断任务完成"的逻辑——这是大模型厂商训练好的能力。
第 4 段:执行工具
for tool_call in assistant_msg.tool_calls:
    name = tool_call.function.name
    try:
        args = json.loads(tool_call.function.arguments or "{}")
    except json.JSONDecodeError as e:
        result = f"参数 JSON 解析失败: {e}"
    else:
        print(f"[step {step}] 调用 {name}({args})")
        try:
            result = TOOLS_IMPL[name](**args)
        except Exception as e:
            result = f"工具执行报错: {type(e).__name__}: {e}"

    messages.append({
        "role": "tool",
        "tool_call_id": tool_call.id,
        "content": str(result),
    })
注意一个 for 循环里有 两个 try/except:
- 第一个 try 包
json.loads——模型偶尔会给坏 JSON 作参数 - 第二个 try 包真正的工具执行——文件不存在、权限不够、超时...
关键技巧 ★(全章 take-away):
工具报错时不要
raise,而是把错误信息作为字符串塞回 messages。
为什么?因为模型下一轮会读到"哦上次工具失败了:FileNotFoundError",然后它会自己想办法:换一个路径试、问用户、跳过这一步……这就是 agent 的鲁棒性来源。
比如,如果模型让 read_file("REA_DME.md")(拼错了),我们的 try/except 会把"FileNotFoundError: REA_DME.md"作为 tool 结果回喂——下一轮模型大概率会修正成 read_file("README.md")。
这一点 pi-main 在 agent-loop.ts:552-639 做得非常工程化(叫 prepare/execute/finalize 三阶段),但思想就是这 10 行 Python。
第 5 段:4 个工具
main.py 顶部还定义了 3 个新工具(外加之前的概念):
def read_file(path: str) -> str: ...
def write_file(path: str, content: str) -> str: ...
def list_dir(path: str = ".") -> str: ...
注意:从这一章起规范使用 pathlib.Path 而不是 open() + 字符串拼接。Windows 路径分隔符 \ 和 macOS/Linux 的 / 不同,pathlib 帮你统一处理。
read_file 还做了截断:
if len(text) > 4000:
    text = text[:4000] + f"\n... (truncated, total {len(text)} chars)"
这是防止读个大日志文件把整个 LLM 上下文撑爆。pi-main 同样会做(tools/read.ts)。
4. 卡住了怎么办
❌ 模型循环一直跑到 MAX_STEPS 强行终止
通常是模型在"读不到文件→重试→还是读不到→重试"。把 MAX_STEPS 调成 3,跑一次失败任务,会看到这种死循环。这就是为什么我们要有这个安全阀。
修复:换个有效的任务,或者改 system prompt 提示模型"如果工具持续报错就停下来问用户"。
❌ OpenAI API error: tool_call_id ... not matched
99% 是你改代码时把 messages.append(assistant_msg) 那行漏了。OpenAI 协议要求 tool_calls 和 tool 结果消息严格配对。
❌ FileNotFoundError 直接抛到外面(agent 崩了)
说明你试题做错了——本章关键就是用 try/except 把错误回喂给模型。检查 _execute_tool 里第二个 try/except 是不是写漏了。
❌ 中文路径乱码
pathlib.Path 默认用系统编码读文件。Windows 上中文文件名通常没问题。如果遇到,加 encoding="utf-8" 参数:
Path(path).read_text(encoding="utf-8")
我的代码已经加了。
5. 思考题
题 1:多步任务
让 agent 执行这个任务:
"读取 main.py 文件的第一行内容,把它写到一个新文件叫 first_line.txt"
观察 [step 0]、[step 1] 打印出来——你会看到 agent 自己先 read_file 再 write_file,两次工具调用串起来了。这就是 ch01 做不到的事情。
跑完后用 dir first_line.txt(Windows)或 ls first_line.txt(macOS)验证文件真的生成了。
题 2:看错误回喂
故意让 agent 跑一个会失败的任务:
"读取 not_exist_at_all.txt 文件,告诉我内容"
观察会发生什么。你应该看到:
[step 0]工具调用失败:工具执行报错: FileNotFoundError ...- 模型读到错误,下一轮不再硬试,而是用中文告诉你"那个文件不存在"
这一题是全章的精髓:agent 因为有"错误回喂"机制,所以失败时优雅。
题 3:删 try/except 看后果
把 _execute_tool 里第二个 try/except 注释掉(让异常直接 raise):
# try:
result = TOOLS_IMPL[name](**args)
# except Exception as e:
#     result = f"工具执行报错: {type(e).__name__}: {e}"
再跑一遍题 2。这次 agent 直接崩——你会看到 Python 抛出 FileNotFoundError 而不是优雅回应。
对比这两次的体验,你会刻骨铭心地记住:工具异常必须用 try/except 兜底回喂给模型。
这一章你学会了什么
- ✅ agent 循环的 10 行核心代码(背下来)
- ✅ 停止条件 = 模型这次返回没有 tool_calls
- ✅
MAX_STEPS安全阀防死循环 - ✅ 错误回喂技巧:工具异常作为字符串塞回 messages,让 agent 自己恢复
- ✅ 用
pathlib.Path写跨平台代码
下一章 ch03:把这个"一次性 agent"包成 REPL,让你可以持续对话,并加上"危险工具的执行前确认"。