
04Bread Browser · 第 1 章
总进度 22 / 33Hello Playwright
让模型操作浏览器,需要分清谁做决定、谁执行动作。模型可以提出点击或输入请求,真正控制页面的工作交给 Playwright:
2026-09-28约 20 分钟50 行代码难度 ★
如果想获取全套课程资料,请关注微信公众号 「AI面包君」,回复 「课程资料」 即可领取。
1. 先用代码打开一个网页
让模型操作浏览器,需要分清谁做决定、谁执行动作。模型可以提出点击或输入请求,真正控制页面的工作交给 Playwright:
LLM 决策          ←→   浏览器执行
(点 [3] 按钮)         (Playwright 真的点)
这一章先不接模型,只用 Python 启动浏览器、打开网页并读取内容。把这部分跑通,后面才能分清问题出在模型选择还是浏览器执行。
3 件事:
- 启动一个浏览器。
- 用
page.goto()打开网页。 - 读取页面内容,并保存一张截图。
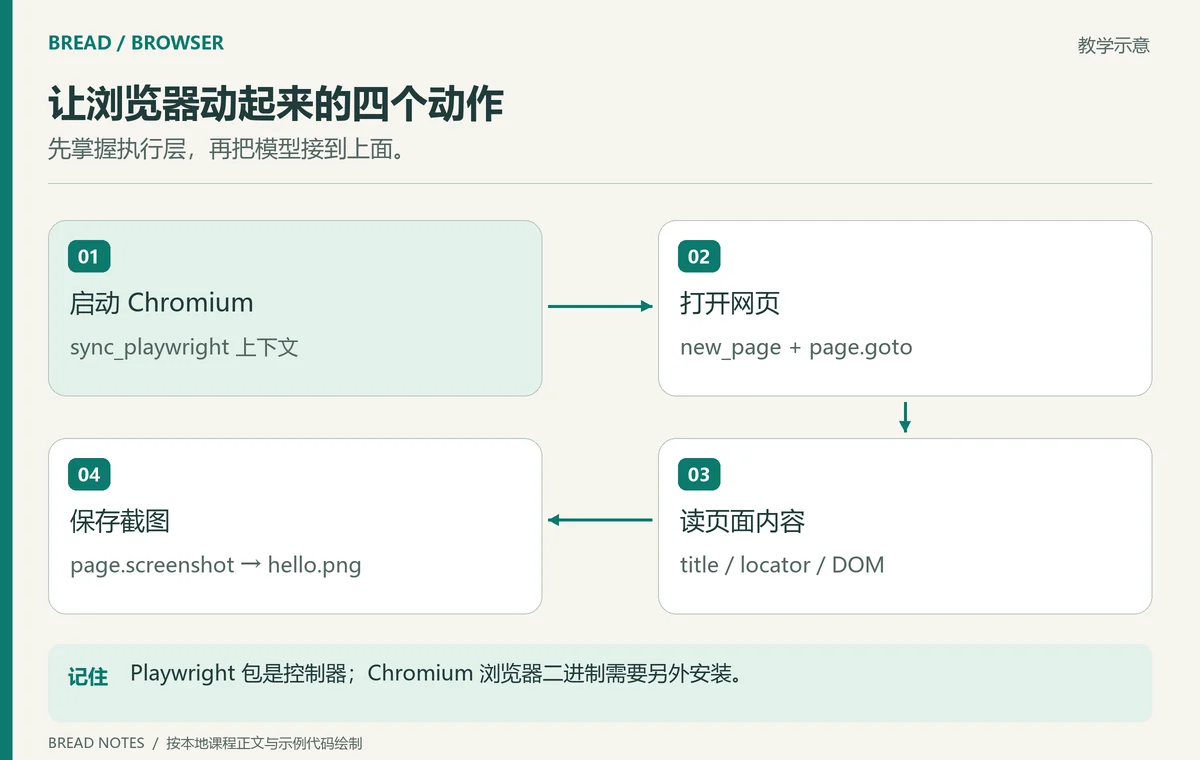
<!-- bread-visual:end -->图解: 先掌握执行层,再把模型接到上面。 Playwright 包是控制器;Chromium 浏览器二进制需要另外安装。
2. 跑起来
安装
pip install -r ../requirements.txt
python -m playwright install chromium
第二行很关键:Playwright 跟其他库不同,包本身只是个"控制器",还要单独装浏览器二进制。如果你跳过这一步,下一步会报 Executable doesn't exist。
跑
cd ch00_hello
python main.py
预期输出
你会看到:
- 浏览器窗口打开。
- 页面进入
quotes.toscrape.com。 - 停留两秒后关闭。
- 当前目录生成
hello.png截图。
终端打印:
[1/4] 启动 Chromium...
[2/4] 新建一个标签页...
[3/4] 打开 https://quotes.toscrape.com ...
  网页标题: Quotes to Scrape
  H1 文本: Quotes to Scrape
  第一条引言: "The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking."...
[4/4] 截图存到 hello.png

完成 ✓  打开 hello.png 看截图
试读到这里 · 后续内容已封存
关注公众号,继续把这章学完
在「AI面包君」发送关键词「学习AI」拿到口令。验证一次,这个浏览器就能继续阅读全部课程。