
13|哪些失败值得再试一次
资料请求偶尔超时,第二次可能恢复;计划字段写错,重复一百次也不会变对。这一节先让一个步骤故意失败一次,观察自动重试,再检查当前实现到底会重试哪些异常。
如果想获取全套课程资料,请关注微信公众号 「AI面包君」,回复 「课程资料」 即可领取。
资料请求偶尔超时,第二次可能恢复;计划字段写错,重复一百次也不会变对。这一节先让一个步骤故意失败一次,观察自动重试,再检查当前实现到底会重试哪些异常。
你要学会的是按失败原因决定下一步,而不是给每个错误都包一层循环。
1. 触发一次可恢复的失败
在项目根目录运行:
.\.venv\Scripts\python.exe labs.py 13
实验通过 engine.fail_once 让第一项资料任务在首次尝试时抛出读取超时。应看到 retry 事件,接着同一步尝试次数变为 2,最终任务进入待人工审核。
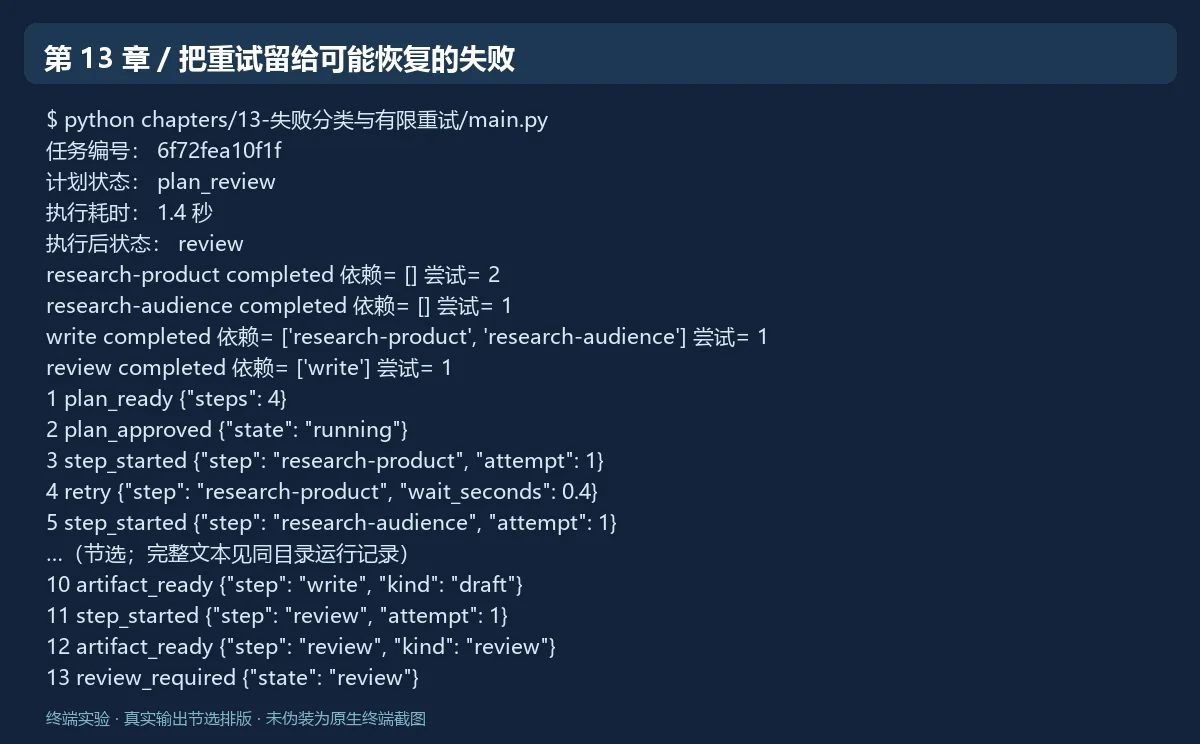
图中内容来自课程实验的实际输出,按阅读宽度排成终端记录;任务编号和耗时会随每次运行变化。
这是主动注入的教学故障,没有拔掉网络。它适合稳定验证重试分支,但不能代表各种真实网络故障都已测试过。
把失败想成三种敲门结果
你去取一份资料:门口暂时没有信号,过一会儿可能恢复;工作人员说你没有权限,重复敲门不会自动获得权限;你拿错了申请表,继续交同一张表也不会变正确。
在程序里,临时网络问题、明确拒绝和无效输入也需要不同处理。自动重试只适合一部分暂时性失败,而且每次尝试都会占用时间,某些请求还会产生费用或副作用。
本课把策略限制得很小:指定的传输异常和超时最多再试一次,其他错误先记录出来。它不是适用于所有系统的最终策略,但比“所有异常都无限重试”更容易解释和验证。
2. 读懂“两次尝试”而不是“两次重试”
one_step 外层使用 for attempt in range(2),总共最多进入两次。内部只对以下异常执行自动重试:
except (httpx.TransportError,TimeoutError):
    if attempt==1:raise
    self.store.change(job_id,lambda j:None,'retry',{'step':sid,'wait_seconds':0.4})
    await asyncio.sleep(0.4)
第一次失败时 attempt 为 0,记录等待事件并停 0.4 秒,再试一次。第二次失败时值为 1,直接抛出异常。因此“最多两次尝试”包含首次调用,不是首次调用之外再试两次。
试读到这里 · 后续内容已封存
关注公众号,继续把这章学完
在「AI面包君」发送关键词「学习AI」拿到口令。验证一次,这个浏览器就能继续阅读全部课程。