
06|两项资料一起查,什么时候才能开始写
串行执行容易理解,但两项独立的资料任务没必要相互等待。这一节把它们同时启动,再让写作等两项结果都到齐。你会读懂调度器怎样挑出可执行任务,以及 Python 的 asyncio.gather 在这里负责什么。
如果想获取全套课程资料,请关注微信公众号 「AI面包君」,回复 「课程资料」 即可领取。
串行执行容易理解,但两项独立的资料任务没必要相互等待。这一节把它们同时启动,再让写作等两项结果都到齐。你会读懂调度器怎样挑出可执行任务,以及 Python 的 asyncio.gather 在这里负责什么。
并行解决等待,依赖保证顺序
做早餐时,烤面包和煮咖啡可以同时开始;装盘却得等需要的食物准备好。这就包含两条规则:互不依赖的步骤可以一起做,需要前序产物的步骤要等条件满足。

把图里的两份资料换成“产品事实”和“目标读者”,写作者若只等到产品资料就开工,很可能写出内容正确却不适合读者的文章。因此并行不只是把两个函数放进 gather,还要定义汇合条件:两份都成功才能继续,还是其中一份缺失也能写一个带说明的草稿?课程这一节先采用前者。
并发表示多项工作在同一段时间内向前推进,并不承诺它们每个 CPU 指令都同时执行。本课用 asyncio 处理等待和调度;它适合演示多个网络任务交错推进,不意味着随手加上 async 就能让任何计算加速。
1. 做一组串行与并行对照
在项目根目录依次运行两条命令:
.\.venv\Scripts\python.exe labs.py 5
.\.venv\Scripts\python.exe labs.py 6
比较“执行耗时”,同时确认四项任务都完成。实验会给每步留一小段等待时间,所以能看见并行带来的差别;这个耗时不代表真实模型的生产性能,也不必与截图精确相等。
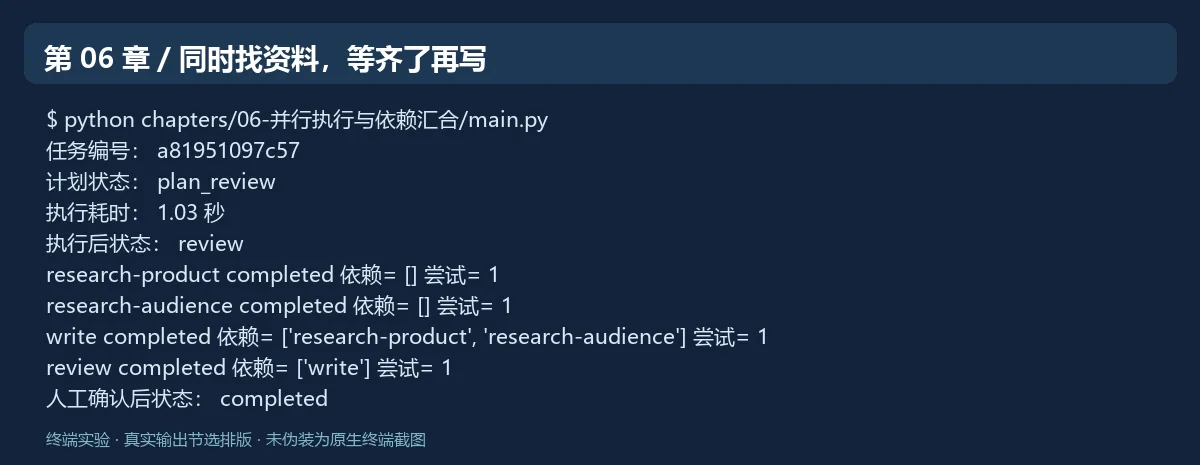
图中内容来自课程实验的实际输出,按阅读宽度排成终端记录;任务编号和耗时会随每次运行变化。
如果两次很接近,先检查机器负载和输出的并行设置。这里观察的是依赖不变时如何安排等待,不是比较文章质量。
先算一笔时间账
假设整理产品资料要 2 秒,受众资料要 5 秒,写作要 3 秒,审校要 2 秒。这里用假设时间说明关系,不是课程机器的实测数据。
全部串行是 2+5+3+2,共 12 秒。两项资料同时开始时,写作要等较慢的那项,所以资料阶段是 max(2,5)=5 秒,总时间约为 5+3+2=10 秒。不能把四个任务都同时做,因为写作还没拿到资料,审校还没拿到稿件。
试读到这里 · 后续内容已封存
关注公众号,继续把这章学完
在「AI面包君」发送关键词「学习AI」拿到口令。验证一次,这个浏览器就能继续阅读全部课程。