
05|上一个助手做完了,怎样交给下一个
资料助手输出一大段文字,不等于写作助手就能正确接住。双方还得约定资料放在哪里、用什么编号领取、怎样保留出处。这一节先按串行顺序跑四个任务,再追踪一份资料从产生到写作输入的过程。
如果想获取全套课程资料,请关注微信公众号 「AI面包君」,回复 「课程资料」 即可领取。
资料助手输出一大段文字,不等于写作助手就能正确接住。双方还得约定资料放在哪里、用什么编号领取、怎样保留出处。这一节先按串行顺序跑四个任务,再追踪一份资料从产生到写作输入的过程。
本节的重点是 artifacts,也就是任务的产物集合。学完后,你应该能从一个任务编号找到它交付的内容,并解释写作为什么只接收自己的依赖产物。
1. 先让任务一个接一个执行
在项目根目录运行:
.\.venv\Scripts\python.exe labs.py 5
实验设置了 parallel=False,所以即使两项资料互不依赖,也先后执行。观察四个编号都变为 completed,随后总任务进入 review。子任务全部完成后仍需人工审核,不要把两层状态混在一起。
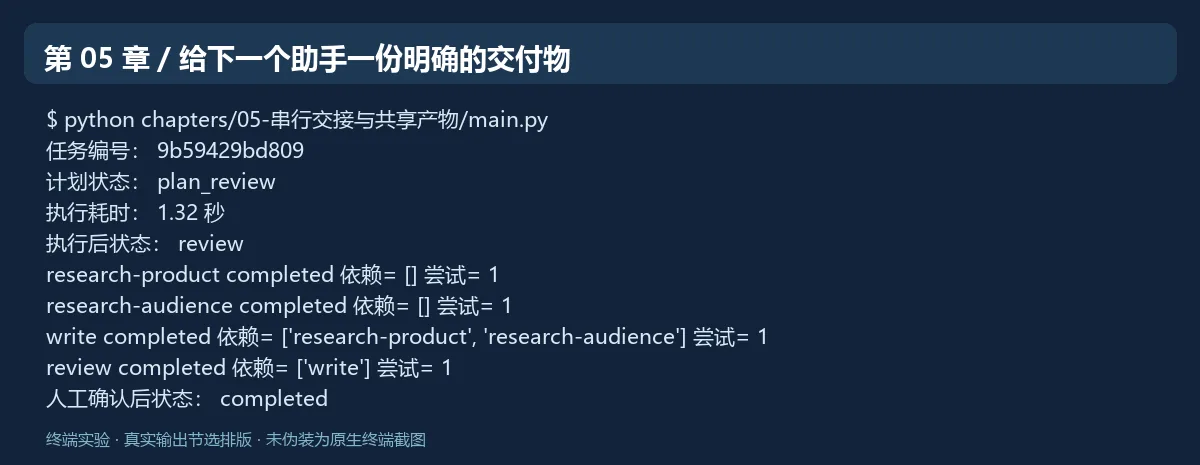
图中内容来自课程实验的实际输出,按阅读宽度排成终端记录;任务编号和耗时会随每次运行变化。
用接力做饭理解“交接物”
一个人洗菜,一个人炒菜。洗菜的人说“我已经很认真地完成任务了”,后面的人仍然不能下锅;他需要实际拿到洗好的菜,还要知道菜是什么、有没有处理过。协作程序也是如此:状态 completed 是完成标记,artifact 才是后续真正用到的东西。
在文章任务里,资料助手不能只交一句“查完了”。至少要给来源编号、标题和内容,写作才有事实依据。审校也不能只接收“初稿已经完成”这个状态,它需要稿件本身。
这就是为什么项目把状态与产物分开保存。页面上的绿勾负责告诉你流程进度,展开产物才能检查工作内容。只确认绿勾,不读交接内容,很容易把“程序执行完了”误当成“任务做好了”。
2. 读懂一份资料产物
资料助手返回的字典形状如下。这里只展示一张资料卡,实际可能有多张:
{
    'kind': 'research',
    'sources': [{'id': 'S01', 'title': '课程定位', 'content': '教学资料内容'}],
    'text': '[S01] 课程定位:教学资料内容'
}
kind 告诉后续程序这是什么产物;sources 保留可进一步处理的原始资料;text 方便直接展示或放进模型上下文。字典键名是双方的约定,随意把 sources 改成 references,下游就可能拿不到来源。
在 engine.py 的 one_step 中,成功后会执行这句:
j['artifacts'][sid]=result
这里 sid 是步骤编号。例如资料整理结果放进 artifacts['research-product']。产物归属于明确的步骤,比“把所有输出追加到一个聊天记录”更容易查找和重跑。
试读到这里 · 后续内容已封存
关注公众号,继续把这章学完
在「AI面包君」发送关键词「学习AI」拿到口令。验证一次,这个浏览器就能继续阅读全部课程。